23/09/2026
Perché ChatGPT qualche volta inventa
Puoi spiegarti benissimo e ricevere comunque una risposta sbagliata.
🎧 Prima di iniziare
Jovanotti — Ragazzo fortunato
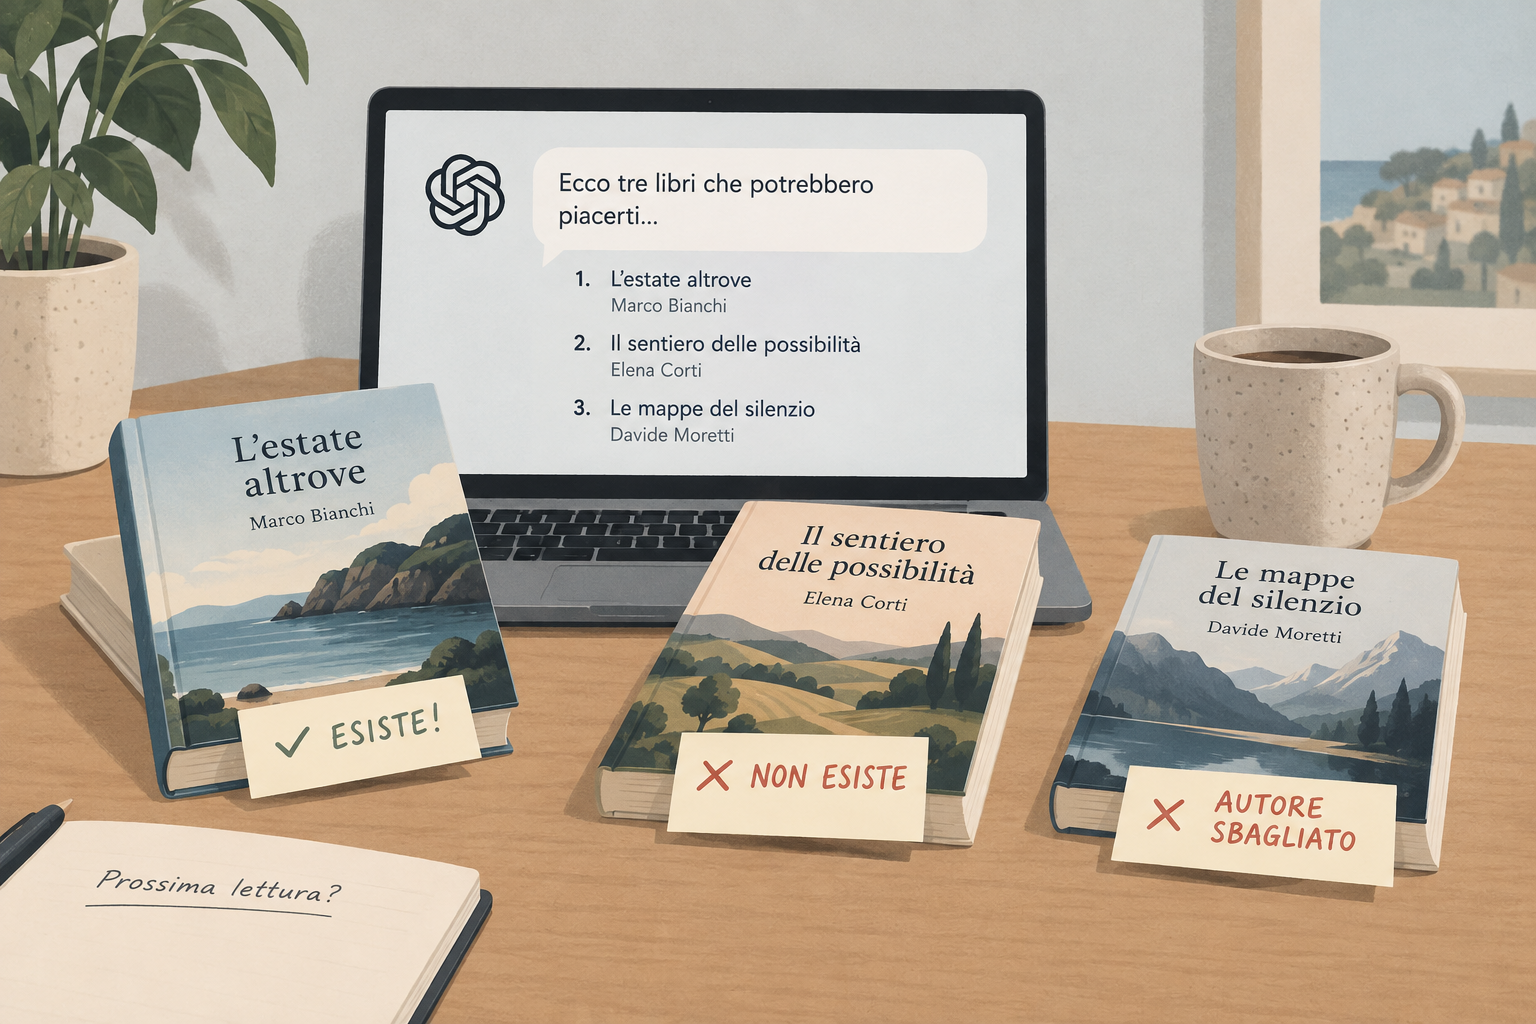
Il romanzo che ti ha consigliato ChatGPT sembra proprio quello giusto per la vacanza. La descrizione ti incuriosisce e l’autore ha un nome che forse hai già sentito. Vai a cercarlo per comprarlo, ma non lo trovi da nessuna parte.
Può succedere che quel libro non esista affatto. Eppure, nella risposta, aveva una trama, un editore e perfino un anno di pubblicazione.
È il problema che avevamo lasciato aperto nell’articolo Che cosa devo scrivere a ChatGPT?. Avevamo lavorato sulla richiesta per ottenere consigli più vicini ai tuoi gusti. Qui, però, aggiungere altre preferenze non risolverebbe molto: il libro suggerito sarebbe perfetto, se qualcuno lo avesse scritto.
Questi contenuti inventati e presentati come informazioni reali vengono chiamati allucinazioni. Possono essere intere risposte, ma anche un dettaglio dentro una spiegazione altrimenti corretta: un nome, una data, una citazione attribuita alla persona sbagliata. OpenAI Help Center
La domanda interessante, a questo punto, è come faccia ChatGPT a descrivere così bene qualcosa che non esiste.
Da dove arriva quel libro?
Per capirlo basta riprendere un passaggio del secondo articolo: il modello costruisce la risposta usando le relazioni apprese durante l’addestramento. Tra le cose che ha imparato ci sono moltissime informazioni reali, ma anche il modo in cui si scrive una recensione o si presenta un libro. Generare quel testo non equivale, di per sé, a controllarlo in un catalogo. OpenAI
Il problema emerge quando manca un’informazione precisa. Sapere che un autore scrive gialli ambientati in montagna non permette di ricavare il titolo di un suo romanzo. Puoi immaginare un titolo adatto al genere, ma per sapere quello vero devi averlo incontrato o andarlo a cercare.
Un modello può produrre proprio quel titolo credibile, invece di fermarsi. Le relazioni che ha appreso gli consentono di costruire una risposta sensata anche quando non sono sufficienti a ricostruire correttamente il fatto. Questo è particolarmente problematico con informazioni rare e specifiche, che non si possono dedurre da uno schema generale. OpenAI
Nel nostro esempio, quindi, ChatGPT potrebbe aver rispettato tutte le preferenze di lettura e aver sbagliato la cosa più importante: l’esistenza del libro.
Perché non dice semplicemente «non lo so»?
Sarebbe la risposta più utile, in molti di questi casi. Uno studio del settembre 2025, firmato da ricercatori di OpenAI e Georgia Tech, spiega però uno dei motivi per cui i modelli possono continuare ad azzardare una risposta: il modo in cui vengono valutati. arXiv
Pensa a un quiz nel quale ogni risposta corretta vale un punto. Se sbagli prendi zero, ma prendi zero anche se lasci la domanda in bianco. Quando non conosci la soluzione, tentare conviene: magari indovini.
Un sistema di valutazione costruito così può favorire un modello che risponde quasi sempre rispetto a uno che riconosce più spesso la propria incertezza. Quello prudente evita alcuni errori, ma rinuncia anche ai punti che avrebbe potuto ottenere indovinando.
Il test, da solo, non provoca le allucinazioni. Quando però questi punteggi orientano lo sviluppo dei modelli, rischiano di premiare proprio il comportamento che vorremmo evitare. Per gli autori dello studio, occorre quindi cambiare anche i criteri di valutazione, penalizzando gli errori sicuri di sé più delle ammissioni di incertezza. arXiv
È una distinzione che interessa anche noi: preferiamo ricevere comunque una risposta, oppure sapere quando non ci sono elementi sufficienti per darcela?
Il tono sicuro non è una prova
Torniamo per un momento al libro.
Se un amico ti dicesse «mi pare che si intitoli così, ma potrei confondermi», sapresti di dover controllare. La sua esitazione farebbe parte dell’informazione che ti sta dando.
Con ChatGPT non puoi contare su questo segnale. Una risposta sbagliata può avere lo stesso tono tranquillo e preciso di una corretta. Anche l’anno di pubblicazione e il nome dell’editore, che sembrano confermare l’affidabilità del consiglio, possono essere inventati. La sicurezza con cui viene scritta una risposta non misura quanto sia vera. OpenAI Help Center
È la parte più insidiosa: per accorgerti dell’errore devi spesso conoscere già l’argomento. Ma magari hai fatto la domanda proprio perché non lo conoscevi.
Chiedere ancora «sei sicuro?» non aggiunge, da solo, una prova. Per verificare quel libro serve qualcosa che vada oltre un’altra rassicurazione nella stessa conversazione.
Quanto vale la pena controllare?
Controllare ogni parola sarebbe poco pratico. Proverei invece a partire da una domanda: che cosa succede se questa informazione è sbagliata?
Quando fai riscrivere una mail, puoi giudicare direttamente se il tono ti piace e controllare che il significato sia rimasto quello che volevi. Anche lì, però, una frase più elegante non giustifica aver cambiato la data dell’appuntamento.
Se invece stai usando un dato per preparare una relazione o prendere una decisione, vale la pena fermarsi su quel dato. Può bastare un numero sbagliato a rendere poco utile una spiegazione scritta benissimo.
ChatGPT può anche cercare informazioni sul web: questo gli permette di consultare fonti, invece di affidarsi soltanto a ciò che ha appreso. Quando la correttezza conta, resta utile aprire il riferimento e leggere il passaggio che dovrebbe sostenere la risposta. È anche l’indicazione di OpenAI: verificare le informazioni importanti, comprese citazioni e fonti. OpenAI Help Center
Nel terzo articolo avevamo cercato di far arrivare al modello quello che avevi in mente. Adesso possiamo aggiungere un criterio per leggere ciò che torna indietro: oltre a chiederti se la risposta ti serve, chiediti su che cosa si basa.
E lascia un po’ di spazio anche a una risposta meno soddisfacente. Un «non lo so» non ti avrebbe trovato il romanzo per le vacanze, ma ti avrebbe almeno risparmiato la ricerca di un libro inesistente.
Fonti e approfondimenti
OpenAI, Why language models hallucinate, 5 settembre 2025: una spiegazione divulgativa della ricerca sull’origine delle allucinazioni e sul ruolo delle valutazioni.
https://openai.com/index/why-language-models-hallucinate/
OpenAI Help Center, Does ChatGPT tell the truth?: i limiti delle risposte e le indicazioni per verificarle.
https://help.openai.com/en/articles/8313428-does-chatgpt-tell-the-truth
Kalai et al., Why Language Models Hallucinate, arXiv:2509.04664, settembre 2025: lo studio sul rapporto tra valutazione dei modelli, incertezza e allucinazioni.
https://arxiv.org/abs/2509.04664
Questo articolo è disponibile anche su Substack.
Leggi su Substack →